 Prepa Help
Apprentissage automatique : k plus proches voisins et k-moyennes, cours et exercices corrigés de prépa
Apprentissage supervisé et non supervisé, données d'apprentissage et de test, distance, algorithme des k plus proches voisins et vote majoritaire, matrice de confusion, choix de k, algorithme des k-moyennes, centres, partition, inertie, initialisation et arrêt, complexités.
- 17méthodes
- 36exercices corrigés
- 6problèmes
- 18pièges
- 45figures
L'apprentissage supervisé prédit la classe d'une donnée nouvelle à partir de données déjà étiquetées ; l'apprentissage non supervisé regroupe des données sans étiquette. Le chapitre traite les deux algorithmes du programme d'informatique de deuxième année, en MP, PSI et TSI au Maroc et en MP, PC, PSI, PT, TSI et TPC en France. Il écrit en Python l'algorithme des k plus proches voisins avec distance euclidienne : calcul des distances, sélection des k plus petites sans trier, vote par une liste de compteurs, en par prédiction. Il montre pourquoi normaliser les attributs, construit et lit la matrice de confusion et choisit k sur des données de test. Il écrit ensuite l'algorithme des k-moyennes : affectation au centre le plus proche, recalcul des centres, arrêt, groupe vide, inertie, et observe la convergence vers un minimum local. Les problèmes reprennent des sujets d'informatique du CNC 2024, 2025 et 2026 (pluie du lendemain, code postal, fleurs d'iris, segmentation d'une image) et du CCINP 2026 (spectres de galaxies et d'étoiles).
Ce que tu sauras faire
Au coin des pesées de la coopérative, deux trieurs ne classent pas les dattes de la même façon. On voudrait qu'une machine propose la variété d'une datte d'après ses mesures, en la comparant aux dattes déjà classées par le connaisseur. Puis, pour les lots du jour, qui n'ont pas d'étiquette, on voudrait former d'elle-même des calibres. Ce chapitre présente les deux algorithmes du programme qui répondent à ces deux questions : les k plus proches voisins et les k-moyennes.
- distinguer apprentissage supervisé et non supervisé, classification et segmentation ;
- représenter des données par des listes d'attributs et des classes numérotées ;
- écrire une distance et normaliser des attributs quand l'énoncé le demande ;
- dérouler à la main et écrire l'algorithme des k plus proches voisins ;
- construire et lire une matrice de confusion, et s'en servir pour choisir k ;
- dérouler à la main et écrire l'algorithme des k-moyennes, calculer une inertie ;
- observer la convergence vers un minimum local ;
- justifier les complexités.
L'essentiel : k plus proches voisins Extrait gratuit
- Distances de l'objet à chaque donnée d'apprentissage : .
- Les plus petites, sans trier : recherches du minimum parmi les non pris, ; à égalité, le plus petit indice.
- Vote par une liste de compteurs : ; à égalité, la classe de plus petit numéro.
Pas de phase d'apprentissage : tout se calcule à chaque prédiction. À deux classes, impair.
def plus_proches(D, k):
    n = len(D)
    pris = [False] * n
    vois = []
    for t in range(k):
        m = -1
        for i in range(n):
            if not pris[i] and (m == -1 or D[i] < D[m]):
                m = i
        pris[m] = True
        vois.append(m)
    return vois

def vote(Y, vois, c):
    cpt = [0] * c
    for i in vois:
        cpt[Y[i]] = cpt[Y[i]] + 1
    gagnante = 0
    for j in range(1, c):
        if cpt[j] > cpt[gagnante]:
            gagnante = j
    return gagnante

def knn(X, Y, x, k, c):
    D = distances(X, x)
    vois = plus_proches(D, k)
    return vote(Y, vois, c)
Une méthode du chapitre Extrait gratuit
« Écrire la fonction knn », « quelle classe prédit l'algorithme pour k = 1, 3, 5 ».
Distances, sélection des plus proches, vote ; coût d'une prédiction (cours, sections 3.5 et 3.6).
- Reprendre les fonctions des questions précédentes (distance, sélection, vote), même non traitées : elles sont admises.
- Écrire
knnen trois lignes : distances, voisins, vote. - À la main : calculer les distances, les ranger, lire les premières, compter.
- Faire varier et dire si la décision change.
- Donner le coût, en fonction de toutes les tailles.
« knn calcule les distances, sélectionne les plus petites puis fait voter les voisins ; on réutilise les fonctions des questions précédentes. Coût : . »
for k in [1, 3, 5]:
    print(k, knn(PLATEAUX, ETAT, INCONNU, k, 2))
Le programme affiche :
1 0
3 0
5 1
Avec , les voisins sont les plateaux 3, 7, 1, 5 et 4 : deux prêts et trois à reprendre.
- Réécrire la distance ou le tri au lieu d'appeler les fonctions précédentes.
- Paramètres dans un autre ordre que celui de la signature.
- Un
returndans la boucle, qui arrête au premier voisin.
Exercices 3, 16 et 29 ; problèmes 1 et 2.
Un exercice corrigé Extrait gratuit
Huit points du plan sont déjà classés en deux classes, 0 et 1. On veut classer le point .
X3 = [[1, 3], [5, 4], [3, 4], [0, 0],
      [2, 2], [4, 6], [6, 6], [1, 0]]
Y3 = [0, 1, 1, 0, 0, 1, 1, 0]
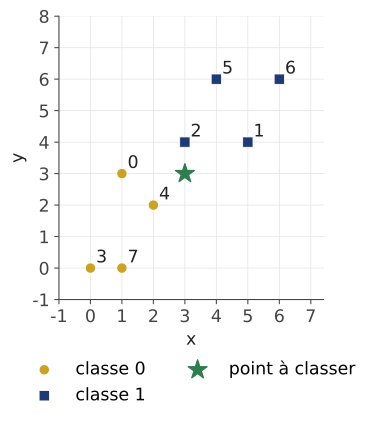
- Calculer le carré de la distance de à chaque point.
- Ranger les points du plus proche au plus lointain.
- En déduire la classe prédite pour , et .
- Contrôler par programme.
- Méthode 7 : distances, sélection des k plus proches, vote.
- Les carrés suffisent pour ranger.
On calcule les huit carrés, sans racine, puis on lit les plus petits dans l'ordre. Pour chaque valeur de , on compte les classes des premiers points et l'on prend la plus représentée. Avec deux classes et impair, il n'y a jamais d'égalité de votes.
Question 1. Carrés des distances à , dans l'ordre des indices :
| indice | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|---|
| point | ||||||||
| classe | 0 | 1 | 1 | 0 | 0 | 1 | 1 | 0 |
| carré | 4 | 5 | 1 | 18 | 2 | 10 | 18 | 13 |
Question 2. Du plus proche au plus lointain : 2 (1), 4 (2), 0 (4), 1 (5), 5 (10), 7 (13), puis 3 et 6 (18 tous les deux ; la règle du cours met 3 avant 6).
Question 3.
- : le seul voisin est le point 2, de classe 1 : est classé 1.
- : points 2, 4, 0, de classes 1, 0, 0 : deux voix pour 0, une pour 1 : classe 0.
- : points 2, 4, 0, 1, 5, de classes 1, 0, 0, 1, 1 : trois voix pour 1 : classe 1.
La décision change deux fois avec : un point situé entre deux classes n'a pas de réponse évidente, et c'est le choix de qui tranche.
Question 4.
D3 = distances(X3, [3, 3])
print(plus_proches(D3, 5))
for k in [1, 3, 5]:
    print(k, knn(X3, Y3, [3, 3], k, 2))
Le programme affiche :
[2, 4, 0, 1, 5]
1 1
3 0
5 1
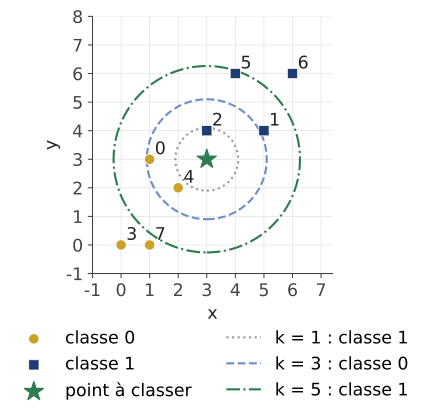
On range les données par distance croissante, puis on fait voter les premières. Le résultat dépend de : on le fixe par l'évaluation sur des données de test, jamais au hasard. Voir les méthodes 7, 5 et 6.
Le cours détaillé, toute la fiche « L'essentiel », 17 méthodes, 18 pièges corrigés, la carte mentale, 36 exercices corrigés, 6 problèmes de concours, les fiches à mémoriser et l'assistant qui répond à tes questions. Ce chapitre est offert : il s’ouvre en entier avec un compte d’essai gratuit.
Ouvrir l'essai gratuitVoir les offresPlan du cours
- 1. Apprendre à partir d'exemples
- 1.1 Au coin des pesées
- 1.2 Intelligence artificielle et apprentissage automatique
- 1.3 Supervisé, non supervisé
- 1.4 Représenter les données
- 1.5 Le Python employé
- 2. Distances
- 2.1 La distance euclidienne
- 2.2 Comparer sans racine
- 2.3 La distance que donne l'énoncé
- 2.4 L'échelle des attributs
- 3. L'algorithme des k plus proches voisins
- 3.1 L'idée
- 3.2 Étape 1 : les distances
- 3.3 Étape 2 : les k plus proches, sans trier
- 3.4 Étape 3 : le vote
- 3.5 Le code complet
- 3.6 Terminaison, correction, complexité
- 3.7 Les égalités
- 4. Évaluer et choisir k
- 4.1 Pourquoi des données de test
- 4.2 La matrice de confusion
- 4.3 Lire la matrice
- 4.4 Choisir k
- 4.5 Régression par les k plus proches voisins
- 5. Segmenter : l'algorithme des k-moyennes
- 5.1 Partition, centre, inertie
- 5.2 L'algorithme
- 5.3 Une trace à la main
- 5.4 Le code
- 5.5 Le groupe vide
- 5.6 Complexité
- 6. Convergence et minima locaux
- 6.1 L'inertie ne croît pas
- 6.2 Un minimum local
- 6.3 Plusieurs départs
- 6.4 Combien de groupes
- 6.5 L'inertie des sujets
- 7. Bilan
- 7.1 Deux algorithmes à ne pas confondre
- 7.2 Les complexités
- 7.3 Vers le chapitre suivant
Les méthodes du chapitre
Chaque méthode est une fiche : quand l'utiliser, le rappel de cours, les étapes, la rédaction attendue sur la copie, un exemple traité, les erreurs à éviter.
- Reconnaître le type de problème
- Représenter les données et respecter la représentation imposée
- Écrire une distance et comparer sans racine
- Normaliser les attributs
- Sélectionner les k plus proches sans trier
- Faire voter les voisins et départager
- Écrire knn et le dérouler à la main
- Construire et lire une matrice de confusion
- Choisir k sur les données de test
- Dérouler les k-moyennes à la main
- Affecter et recalculer les centres
- Écrire les k-moyennes complètes
- Calculer une inertie, comparer des partitions et répéter les départs
- Montrer un minimum local et ne pas choisir k par l'inertie
- Lire et critiquer un code donné
- Prédire une valeur numérique par les k plus proches voisins
- Choisir le nombre de groupes par la méthode du coude
Les exercices corrigés
Chaque exercice a ses indications, sa correction rédigée et ce qu'il faut en retenir.
Application directe (14)
- Supervisé ou non supervisé
- Distances à la main
- Voisins à la main
- Égalités
- Le vote par compteurs
- Lire une matrice de confusion
- Une classe contre les autres
- Normaliser à la main
- Un tour de k-moyennes
- Centre et inertie
- Le rectangle
- Trois questions de cours
- Lire un tableau de réussite
- Lire un coude
Entraînement (16)
- Les k plus petits sans trier
- Reconnaître des caractères
- Les olives de la coopérative voisine
- La matrice en code
- Choisir k
- Normaliser, mesurer, commenter
- Les sons sous-marins
- Affecter
- Recalculer, et le groupe vide
- Les k-moyennes avec un nombre maximal de tours
- Tirer les centres de départ
- Plusieurs départs
- Un code à corriger
- Deux représentations d'une partition
- Estimer un prix par les voisins
- Avec les facilités du langage
Approfondissement (6)
- Les points de collecte
- Frontières de décision
- Le hasard et le minimum local
- Choisir k sans tricher
- Manhattan et moyenne
- L'inertie ne croît pas
Les problèmes de concours
Des extraits de sujets réels, corrigés en entier, avec la durée conseillée et les méthodes mobilisées.
- Va-t-il pleuvoir demain ?
- Lire un code postal
- Regrouper des fleurs d'iris
- Segmenter une image par couleurs
- Classer des spectres de galaxies et d'étoiles
- Le prix d'un téléphone
Questions fréquentes
Comment fonctionne l'algorithme des k plus proches voisins ?
L'algorithme des k plus proches voisins classe un objet nouveau, décrit par une liste d'attributs, à partir de données d'apprentissage dont on connaît la classe. Il se fait en trois étapes. On calcule d'abord la distance euclidienne de l'objet à chaque donnée d'apprentissage, en pour données de attributs. On retient ensuite les données les plus proches, sans trier toute la liste : on cherche fois la plus petite distance non encore prise, en , et à distance égale on garde le plus petit indice. Enfin, les voisins votent : une liste de compteurs, un par classe, donne la classe la plus représentée, et à égalité la classe de plus petit numéro. Une prédiction coûte donc . Il n'y a pas de phase d'apprentissage : on garde les données telles quelles et tout le calcul se fait au moment de chaque prédiction.
Comment choisir la valeur de k ?
On choisit en mesurant la qualité des prédictions sur des données de test, mises de côté, que l'algorithme ne consulte jamais pour voter. On essaie plusieurs valeurs de et l'on compte les bonnes prédictions. Un trop petit rend la décision sensible à une donnée atypique : dans l'exemple des dattes du cours, ne classe bien que 8 dattes de test sur 9. Un trop grand fait voter des données éloignées : avec , toutes les données votent et seules 3 dattes sur 9 sont bien classées. Entre les deux, de à , les 9 dattes sont bien classées ; on prend une valeur au milieu de ce plateau. Avec deux classes, on préfère un impair, qui évite les égalités de votes. On ne mesure jamais la qualité sur les données d'apprentissage : avec , chaque donnée est sa propre voisine, et l'on obtient 100 % quand les données sont deux à deux distinctes, sans rien apprendre.
Pourquoi normaliser les attributs avant de calculer des distances ?
La distance euclidienne additionne les carrés des écarts pris sur chaque attribut. Si un attribut prend de grandes valeurs, ses écarts écrasent ceux des autres, et c'est lui qui décide seul du plus proche voisin. Il suffit de changer d'unité pour le voir : dans l'exemple du cours, la datte de mesures 18 g et 42 mm a pour plus proche voisine la datte 7 quand la longueur est en millimètres, et la datte 9 quand elle est en centimètres ; avec trois voisins, la décision passe de B à A. Pour que chaque attribut compte autant, on le ramène entre 0 et 1 par , où le minimum et le maximum sont calculés sur les données d'apprentissage, en une seule boucle. On normalise ensuite les données de test et toute donnée nouvelle avec ces mêmes bornes ; une valeur normalisée peut alors sortir de l'intervalle de 0 à 1, ce qui n'a rien d'anormal.
Qu'est-ce qu'une matrice de confusion et comment la lire ?
Pour un problème à classes, la matrice de confusion d'un jeu de test est une matrice dont la case compte les données de test de classe réelle que l'algorithme a prédites : les lignes sont les classes réelles, les colonnes les classes prédites. Un énoncé peut prendre la convention inverse, qu'il faut toujours lire avant d'interpréter. Les bonnes prédictions sont sur la diagonale, et l'exactitude, ou taux de réussite, est la somme de la diagonale divisée par le nombre de données de test. Une case hors de la diagonale nomme une confusion précise. Pour étudier une classe contre les autres, on forme un tableau de quatre cases : vrais positifs, faux négatifs, faux positifs et vrais négatifs. Les mesures comme la précision et le rappel se calculent alors avec la formule que donne l'énoncé. En Python, on crée la matrice par compréhension, une ligne neuve par classe, puis on ajoute 1 dans la case de chaque donnée de test.
Comment fonctionne l'algorithme des k-moyennes, et qu'est-ce qu'un minimum local ?
Les k-moyennes regroupent points sans étiquette en groupes. On part de centres, par exemple points distincts du nuage tirés au hasard sans remise. Chaque tour affecte chaque point au centre le plus proche, puis remplace chaque centre par la moyenne des points de son groupe ; on s'arrête quand plus aucune affectation ne change, ou après un nombre maximal de tours. Un tour coûte . L'inertie, somme des carrés des distances de chaque point au centre de son groupe, ne croît jamais d'un tour au suivant ; avec une règle d'égalité fixée, l'algorithme s'arrête. Mais il s'arrête sur un minimum local : une partition que plus aucun tour n'améliore, alors qu'une autre a une inertie plus petite. Dans l'exemple du cours, douze lots de dattes donnent une inertie de 27 depuis un départ, et de 248 depuis un autre. On relance donc depuis plusieurs départs et l'on garde la plus petite inertie.
Quelle différence entre k plus proches voisins et k-moyennes ?
Les deux noms se ressemblent, et le rapport du jury du concours CCINP 2026 (filières PC et PSI) relève beaucoup de confusion entre les deux. Les k plus proches voisins sont un algorithme d'apprentissage supervisé : ils reçoivent des données étiquetées et un objet nouveau, et renvoient une classe, choisie par le vote des données les plus proches. Ici, est le nombre de voisins consultés, et tout le calcul se fait à chaque prédiction. Les k-moyennes sont un algorithme d'apprentissage non supervisé : ils reçoivent des points sans étiquette et renvoient une partition en groupes avec leurs centres, calculée tour après tour jusqu'à l'arrêt. Ici, est le nombre de groupes cherchés. Ce qui peut tromper n'est pas le même non plus : pour les voisins, un mal choisi, des attributs d'échelles différentes ou une évaluation sur les données d'apprentissage ; pour les k-moyennes, le choix des centres de départ, le minimum local et le groupe vide. Sur une copie, écrire « voisins » ou « groupes » montre qu'on ne les confond pas.
Comment y accéder
Ce chapitre fait partie des chapitres offerts : il s'ouvre en entier avec un compte d'essai gratuit pour les filières dont il est l'un des premiers chapitres. Créer un compte d'essai ou se connecter. Pour l'accès complet et les tarifs, vois les offres.